
Audit SEO technique : la checklist pour prioriser les corrections
Une méthode pour transformer un crawl de 230 alertes en plan d'action tenable : ce qu'on corrige maintenant, ce qu'on surveille, ce qu'on ignore.
Un crawl de 800 URLs remonte 230 alertes. Le mauvais réflexe consiste à les traiter dans l'ordre où elles s'affichent. Le bon consiste à comprendre que ces 230 lignes cachent peut-être douze causes.
Voici la méthode que j'applique, dans l'ordre.
1. Commencer par l'indexabilité, toujours
Tant qu'une page ne peut pas être indexée, tout le travail fait dessus est perdu. Réécrire un
title sur une page en noindex, c'est repeindre une pièce murée.
Dans l'ordre :
- Statuts HTTP. Les pages qui comptent répondent-elles en 200 ?
robots.txt. Bloque-t-il quelque chose d'important, souvent par héritage d'une préproduction ?meta robotsetX-Robots-Tag. Unnoindexoublié après une refonte est un classique.canonical. Pointe-t-elle vers la page elle-même, ou vers autre chose ?- Redirections. Chaînes, boucles, et liens internes qui pointent vers une redirection au lieu de la destination finale.
Le symptôme qui doit vous alerter : un écart important entre pages explorées et pages indexables.
2. Regrouper par cause, pas par ligne
C'est l'étape que la plupart des audits sautent, et c'est celle qui divise le travail par dix.
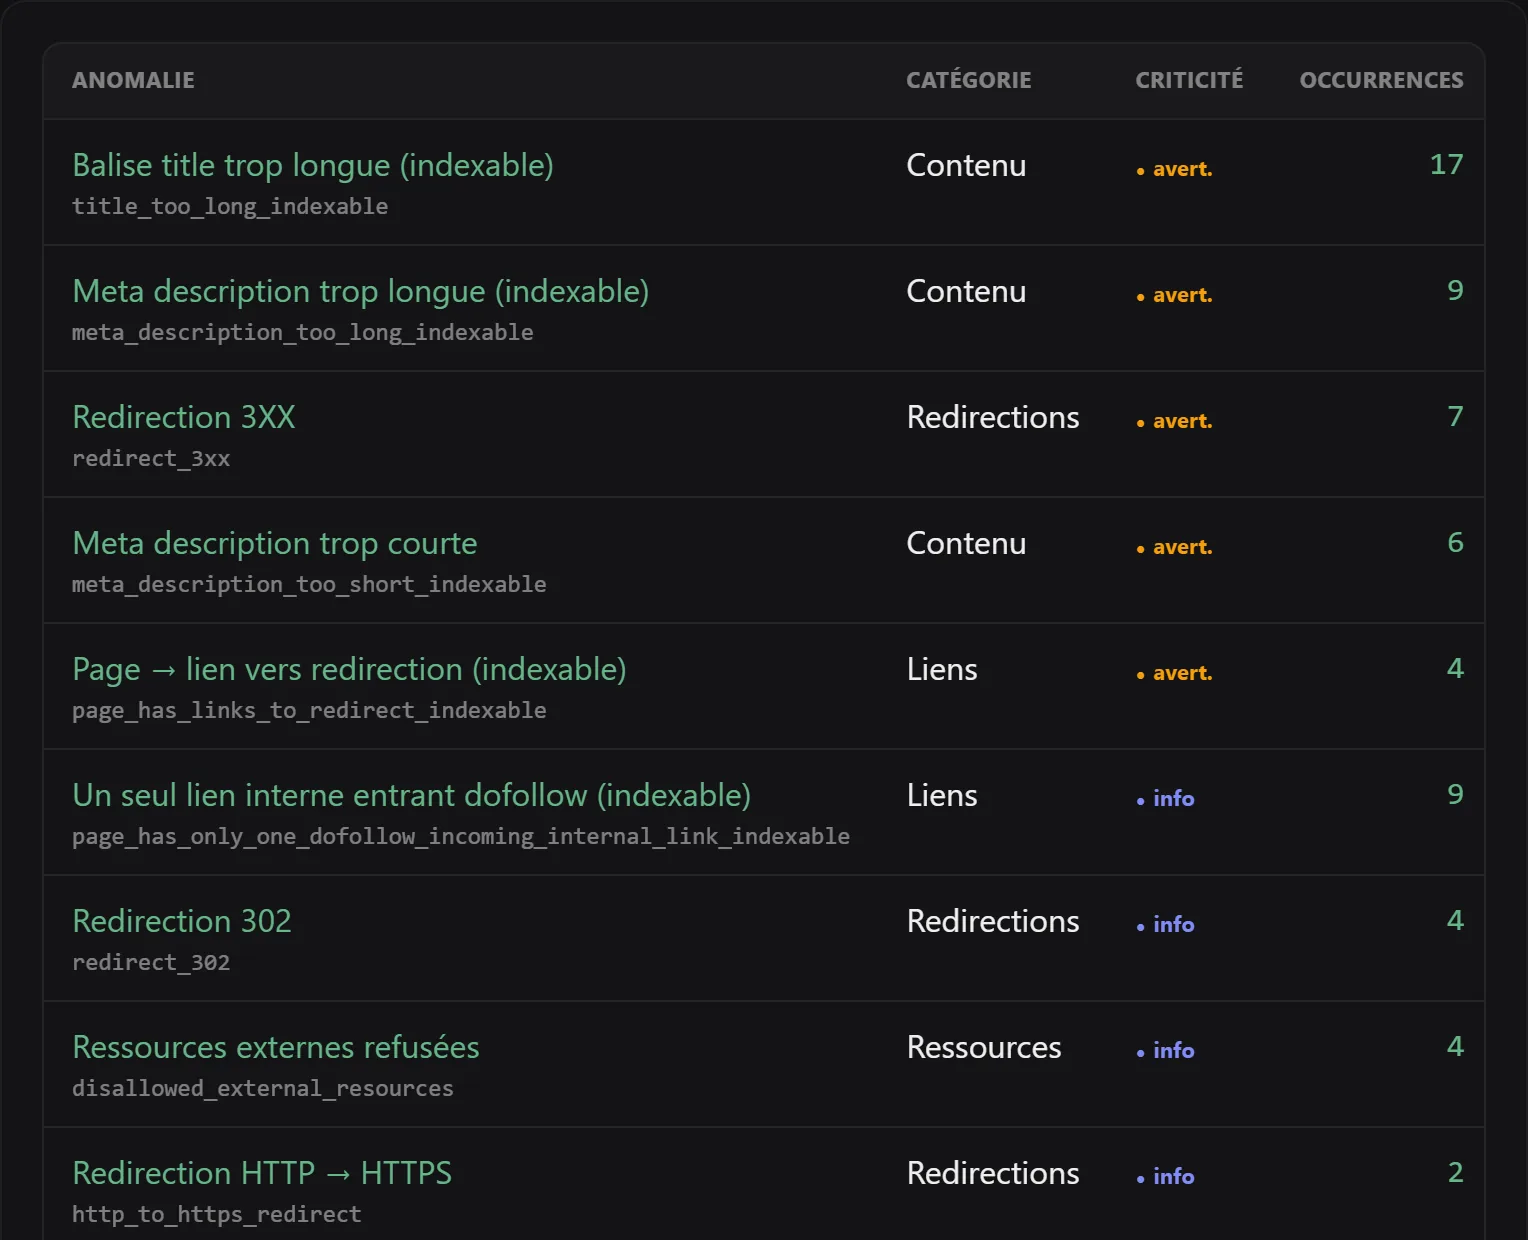
120 meta description manquantes, ce n'est presque jamais 120 problèmes. C'est un gabarit qui
n'émet pas la balise. Une modification, 120 lignes qui disparaissent.
Posez la question pour chaque anomalie volumineuse : est-ce la page ou le gabarit ?
- Toutes les pages d'un même type sont touchées → gabarit.
- Quelques pages éparses → contenu, à traiter au cas par cas.
Cette distinction change complètement l'estimation d'effort. Un audit qui annonce « 230 corrections » sans l'avoir faite annonce un chiffre faux.
3. Croiser avec ce qui rapporte
C'est le filtre le plus discriminant, et il demande Google Search Console.
Une meta description manquante sur une page à 12 000 impressions et la même sur une archive
de 2019 à zéro impression ne méritent pas la même journée de travail. Sans données de
recherche, vous ne pouvez trier que par gravité technique — ce qui revient à traiter les deux
pareil.
Exportez vos pages avec leurs impressions, croisez avec la liste des anomalies, et vous obtenez votre ordre de travail réel.
4. Classer en quatre paniers
| Panier | Contenu | Quand |
|---|---|---|
| Critique | Pages business non indexables, 5xx, canonical incohérente, 404 sur pages liées | Cette semaine |
| Important | Titles dupliqués sur pages à impressions, h1 absents, liens internes cassés, profondeur excessive | Ce mois |
| À surveiller | Descriptions manquantes sur pages secondaires, images sans alt, URLs longues | Prochain lot |
| Ignoré | Alertes sur pages volontairement exclues ou sans aucun potentiel | Jamais, et c'est une décision |
Le quatrième panier est le plus important pour la santé mentale de l'équipe. Décider de ne pas corriger quelque chose est une décision légitime — à condition qu'elle soit écrite.
5. Vérifier, ce qui veut dire recrawler
Une correction déployée n'est pas une correction constatée. Entre les deux il y a un déploiement, un cache, parfois un CDN, et l'hypothèse que le correctif était le bon.
Relancez un crawl après chaque lot et comparez-le au précédent. Deux chiffres à regarder :
- Les anomalies visées ont-elles disparu ?
- Combien d'anomalies nouvelles sont apparues ?
Le second chiffre est celui qu'on oublie. Une correction de canonical qui règle 40 URLs et en
met 12 en noindex est un échec, même si le rapport global s'est amélioré.
6. Écrire le rapport pour son lecteur
Un export brut n'est pas un rapport. Si quelqu'un doit décider d'un budget à partir de votre travail, il lui faut :
- un résumé en cinq lignes ;
- les problèmes critiques avec les URLs concernées ;
- une estimation d'impact et d'effort, honnête, y compris quand l'effort est faible ;
- ce qui a été corrigé depuis la dernière fois, avec la preuve.
Ce dernier point est ce qui transforme un audit ponctuel en mission récurrente. C'est aussi le seul que la plupart des outils ne produisent pas tout seuls, parce qu'il demande de garder la mémoire des corrections précédentes.
La checklist, en résumé
- Exporter les pages indexables et les comparer aux pages explorées.
- Identifier les statuts non-200 sur les pages qui comptent.
- Regrouper chaque anomalie volumineuse par cause : gabarit ou page.
- Croiser avec les impressions Search Console.
- Répartir en critique / important / à surveiller / ignoré.
- Corriger par lot, déployer, recrawler, comparer.
- Écrire ce qui a été fait et ce qui reste.
Questions fréquentes
Quelle est la différence entre un crawl SEO et un audit SEO ?
Le crawl collecte les faits : statuts HTTP, balises, liens, canonicals, profondeur, indexabilité. L'audit interprète ces faits pour décider quoi corriger en premier. Un outil produit le premier ; le second demande de connaître le business.
Faut-il corriger toutes les alertes d'un audit SEO ?
Non, et vouloir le faire est la meilleure façon de ne rien terminer. Traitez ce qui empêche l'indexation, ce qui dégrade l'exploration, et ce qui touche des pages qui rapportent. Le reste attend le prochain passage.
Combien de temps prend un audit SEO technique ?
Le crawl : quelques minutes à quelques heures. L'interprétation : une demi-journée sur un site vitrine, plusieurs jours sur un catalogue. C'est l'interprétation qui coûte, pas la collecte.
Quand relancer un crawl après correction ?
Dès qu'un lot de corrections est déployé. C'est la seule façon de vérifier que les problèmes ont disparu et qu'aucune régression n'est apparue au passage.
Mettre ce guide en pratique
Dans Noyaru, cette priorisation est le tri par défaut de la page Anomalies — et les corrections de gabarit se déclenchent en un clic, en pull request sur votre dépôt.
Créer un compte gratuit Voir la documentation